DeepSeek V4.1 FlashとGPT-6 Astraを比較 価格・性能・日本での導入条件
生成AIの候補を価格表だけで選ぶと、版の変更、再試行、データ処理の条件が導入後の負担になる。DeepSeek V4.1 FlashとGPT-6 Astraの公式情報を分けて読み、日本の利用者が同じ評価データで確認する項目を示す。
生成AIの候補を価格表だけで選ぶと、版の変更、再試行、データ処理の条件が導入後の負担になる。DeepSeek V4.1 FlashとGPT-6 Astraの公式情報を分けて読み、日本の利用者が同じ評価データで確認する項目を示す。
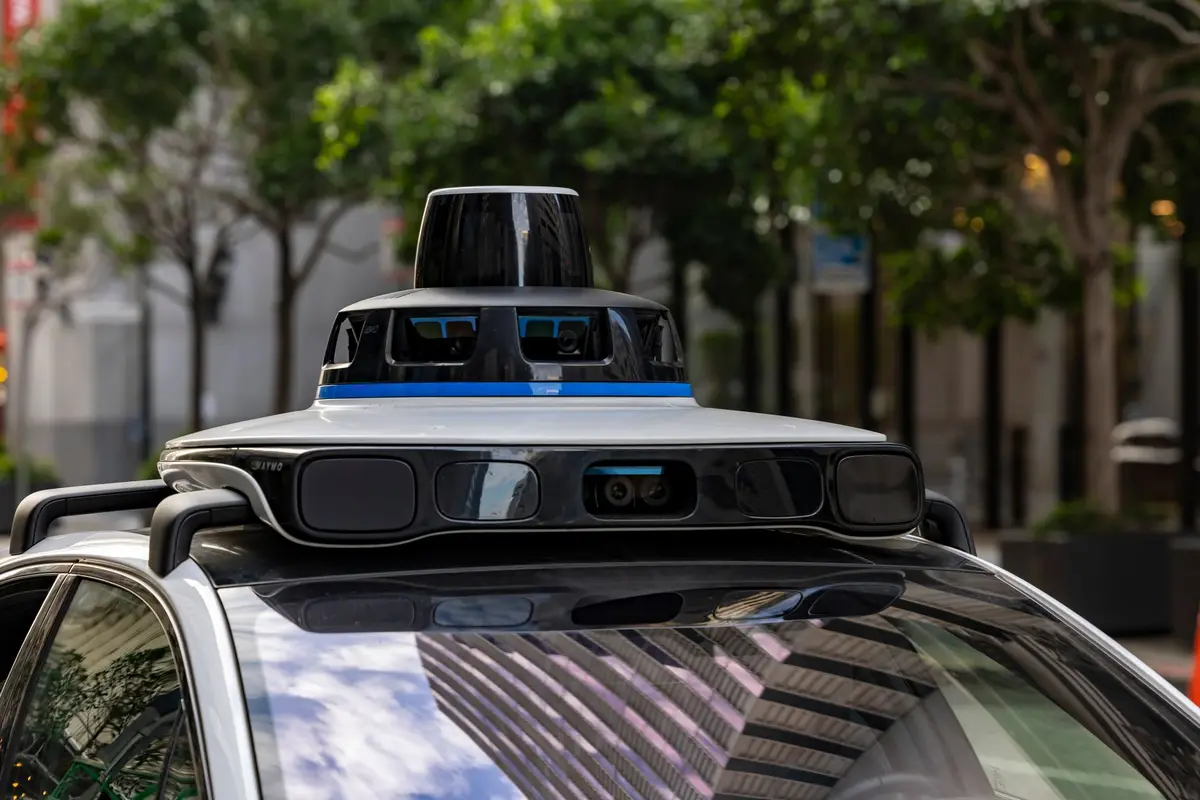
ハンドルもペダルもないテスラのサイバーキャブが、米テキサス州オースティンの限られた区域で乗客を運び始めた。公道運行の可否は、運行設計領域と故障時の停止に加え、車両基準、運行、旅客事業という別々の審査で決まる。
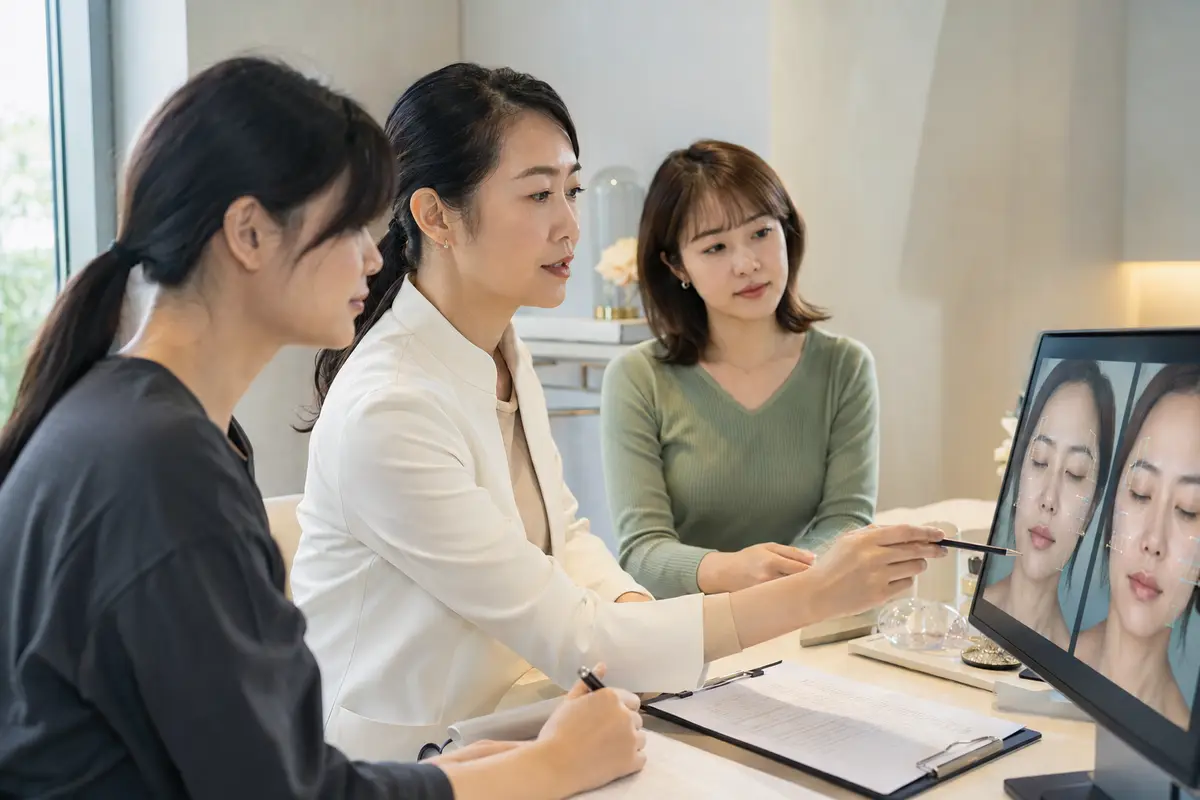
美容鍼の前後でAIが示す「しわの改善率」は、撮影条件や学習データが変われば動きうる。顔画像の数値は外観上の代理指標であり、治療の有効性、安全性、継続の可否には別の臨床評価と医療者の確認が要る。
AIが診療情報を読み、予約を変更し、記録を更新する場面では、モデルの回答精度だけを見ても接続全体の安全性は判断できない。MCPはデータやツールを共通の手順で見つけて呼び出す接続層であり、利用目的、権限、人の確認、監査は導入側が別に設計する。
長時間の開発や複数のツールをまたぐ処理では、正答率に加えて応答時間とトークン消費が実務上の差になる。Gemini 3.8 Flashは推論とツール呼び出しを重ねる設計を強め、low、medium、highの思考レベルで品質、待ち時間、費用の釣り合いを調整する。
AI医療機器の承認時の成績は、患者構成、検査機器、入力条件が変わった後の性能まで保証しない。導入後は入力、出力、患者集団別の成績、不具合、版を同じ時間軸で追い、調査・停止・復旧の判断へつなぐ必要がある。
診療録の要約を返す生成AIと、予約や記録を自ら更新するAIエージェントでは、同じ誤りでも届く範囲が違う。病院で使う前に、読み取り・書き込み・実行の権限を分け、高リスク動作を人の承認に戻し、異常時に停止して従来手順へ切り替える設計が要る。
患者の全身を再現し、治療を自在に試せる医療デジタルツインは、国内で誰もが使える診療サービスになったわけではない。中核となる仕組みは、特定の患者や臓器に結び付くモデルを実データで更新し、検証済みの範囲で仮想条件を比べることだ。
健康診断結果や診療記録から氏名を消しても、受診日や地域、まれな病歴を外部情報と照合すれば本人へ結び付く余地が残る。日本法は仮名加工情報と匿名加工情報を分け、加工方法、対照表の管理、第三者提供の扱いを異なる規律に置く。
生成AIの個人向け有料プランは、同じ月額帯でも保存容量、家族共有、開発機能、利用上限の設計が異なる。日本で選ぶ際は、公開価格の横並びではなく、同じ作業を試した結果とログイン後の決済額、更新条件を照合する必要がある。
Geminiで画像を作ったり直したりする際は、モデル名や長い定型文を覚えるより、変更箇所と残す要素を分けた指示が扱いやすい。Googleの現行案内を基に、Nano Banana 2の入口、七つの指定項目、局所編集と多画像合成、年齢・プラン・解像度の条件を整理する。
医療AIは、画像や検査値、診療録、会話を入力に、分類、予測、要約などを返すが、モデルの出力だけでは臨床の判断にならない。日本で現場へつなぐには、用途と規制上の位置を定め、データ、人の確認、版管理、停止手順を一続きの業務として設計する必要がある。
電子カルテに診断名や検査値が蓄積されていても、項目の意味や時点がそろわなければ医療AIの入力には使えない。FHIRは交換形式を共通化するが、院内では項目対応、権限と監査、臨床での人の確認、製品用途の四つを別々に検証する必要がある。
「天麻の効能」をAIに尋ねると、生薬、ガストロジン、漢方製剤、健康食品の情報が一つの答えに混ざりやすい。安全な検索には、対象製品の身元、人体研究の範囲、公的な添付文書と服薬情報を順に照合し、最終判断を医師や薬剤師に残す設計が要る。
医療AIは全体で高い性能を示しても、年齢、性別、病態、検査機器や施設が変わると、一部の患者で誤りが増える場合がある。偏りの検証では、対象患者を反映した独立データで患者集団別の性能と不確実性を示し、導入後も同じ単位で変化を追う必要がある。
健康管理アプリと診断支援ソフトは、同じAIを使っていても薬機法上の扱いが異なる。日本では製品名やアルゴリズムではなく、使用目的と出力が診療に与える影響、不具合時の危険性を基に、医療機器への該当性と必要な手続きを判断する。
医療AIが誤った出力を返しても、AIという抽象的な主体が責任を引き受けるわけではない。日本の公開資料は、医師の最終判断、製造販売業者の製品管理、医療機関の安全管理、データと版の追跡を別々に記録する構造を示す。
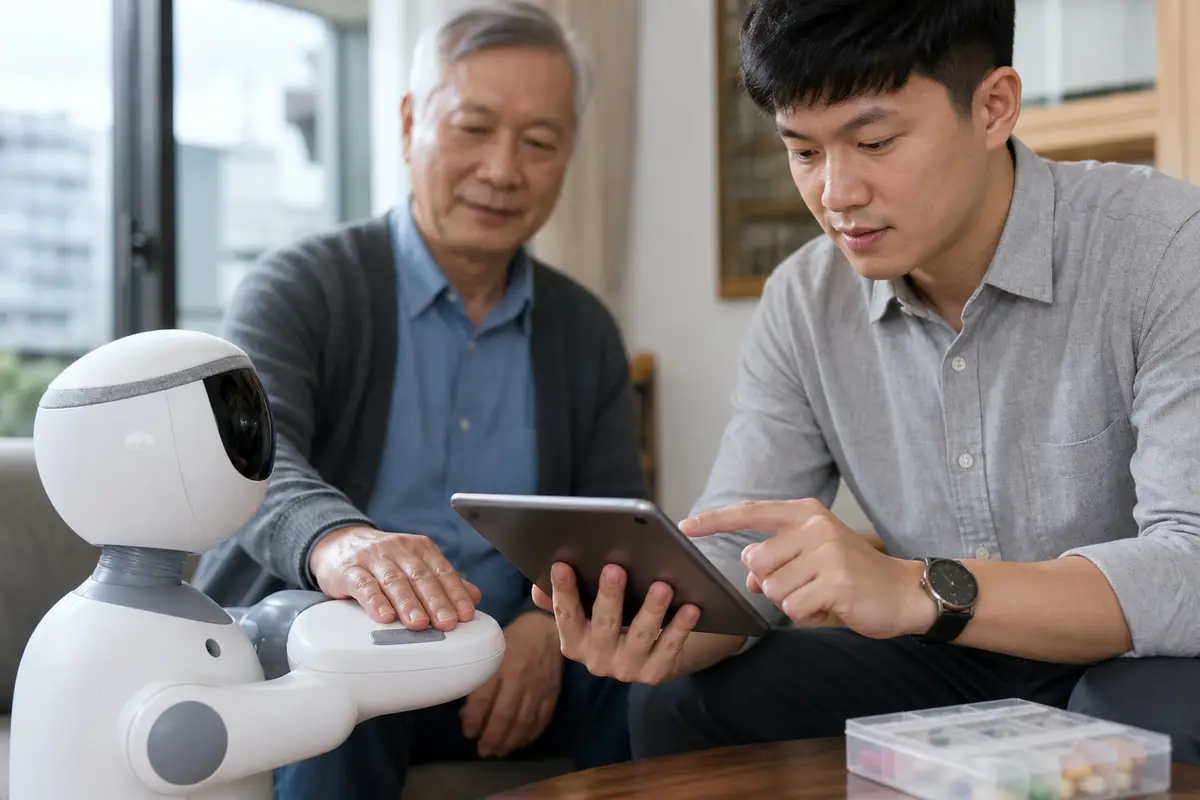
会話や活動のきっかけを作るAIロボットは、日本の介護テクノロジー重点分野にも入っている。認知症ケアで確認された効果は限られ、診療・介護の判断、異常時の接手、音声データの管理は人が担う設計が要る。
医療AIが高い精度を示しても、患者構成や検査機器、データ接続が開発時と違えば、院内で同じ性能を保つとは限らない。病院側は使用目的を固定し、独立データ、人とAIの作業、導入後の変化を別々に検証する必要がある。
公的医療保険の請求データが全国規模でも、AIの臨床性能がそのまま保証されるわけではない。日本のNDBを使うには利用目的と必要最小限の項目を審査に示し、請求データの限界を補ったうえで、対象患者を反映する独立データによる検証が要る。
バイブコーディングでサイトを作れても、公開には実行環境、Git連携、秘密情報、監視、費用の設計が残る。CloudflareがAIの回答に出る頻度を示す公開統計は本稿では確認できず、公式文書の取得しやすさと短いデプロイ経路、エージェント向け手段が候補入りを支えるという仮説が残る。
AI医療機器は、追加学習やソフト更新で出力が変われば、承認時に評価された性能と院内で使う版がずれるおそれがある。日本ではIDATENが将来の変更計画を事前に確認し、病院側には検証結果、版、通知、停止手順を院内記録へ結び付ける作業が残る。
生成AIの業務利用では、最高性能のモデルでも費用、応答時間、データの扱いが現場の条件に合わなければ運用は続かない。先に合格基準と失敗時の損失を決め、同じ評価データで候補を測った後に、版管理と切り替え方まで選定記録へ残す。
AIデータセンターの増設は、演算能力の確保と引き換えに、立地地域へ大きな電力需要と冷却用水、騒音、系統増強費の負担を持ち込む。米国の監査項目と日本の制度を照らすと、年間値に加えてピーク時の電力・水量、冷却方式、接続時期、公共負担を立地前に同じ資料で示す必要がある。
合成データを使った医療AIでは、統計的に本物らしいという説明だけで臨床現場の性能を判断できない。生成元から独立した実患者データ、対象集団別の成績、人とAIを合わせた試験、導入後の監視を一続きの証拠として確認する必要がある。
高い精度を示した医療AIでも、対象患者や院内システム、診療手順が開発時の条件と異なれば、同じ性能を保つとは限らない。病院導入では、用途と停止条件を定め、データ、接続、人による監督、モデル更新を別々に検証する必要がある。
股関節痛の原因は症状入力だけでは確定せず、外傷後の激痛や歩行不能を通常の外来予約へ流せば受診が遅れる。AIトリアージは警告サインの即時昇格、欠落情報の表示、医療者による最終判断までを一つの運用として設計する必要がある。
Google Oneの学生向け特典には、Plusの12カ月無料、Proの学割、YouTube Premiumとのセットが並び、過去の「Pro一年無料」とは条件が異なる。現行の無料枠はGoogle AI Plus(400GB)で、個人アカウントと支払い方法を用意し、学校メールを使ってSheerIDの在学確認を通す。
医療AIには代表性のある患者データが要るが、取得費用やプライバシー、希少例の少なさが開発を縛る。合成データは実データの特徴を計算機上で再現して不足を補う一方、匿名性と臨床的な妥当性を自動では保証しない。
日本の対策型乳がん検診は40歳以上を対象に2年に1回のマンモグラフィを行い、画像は二重読影する仕組みをとる。スウェーデンのMASAI試験は、AIで低リスク画像を一人読影、高リスク画像を二重読影へ振り分け、中間期がん率で標準法への非劣性を示した。
生成AIの業務利用では、処理が長期化するほどトークン費用の管理が難しくなる。OpenAIはGPT-5.6 LunaのAPI料金を8割、Terraを2割引き下げ、中国の低価格・オープンウェイトモデルが伸びる市場で競争を一段と強めた。
診療録作成の負担を減らす目的で、診察中の会話から下書きを作るAIスクライブの導入が米国で広がり、日本でも研究が進む。短期調査では負担軽減との関連が示されたが、日本の既存制度では医師の最終確認と医療機関・事業者間の責任分界が導入の前提になる。
AIアクセラレーターは、カタログ上の演算性能だけで選ぶと、入力処理やメモリー、低い稼働率が隠れた費用になる。モデルの変更頻度から3年間の総保有費用までを同じ表に置き、自社の通常時、ピーク時、障害時の負荷で候補を比べる。
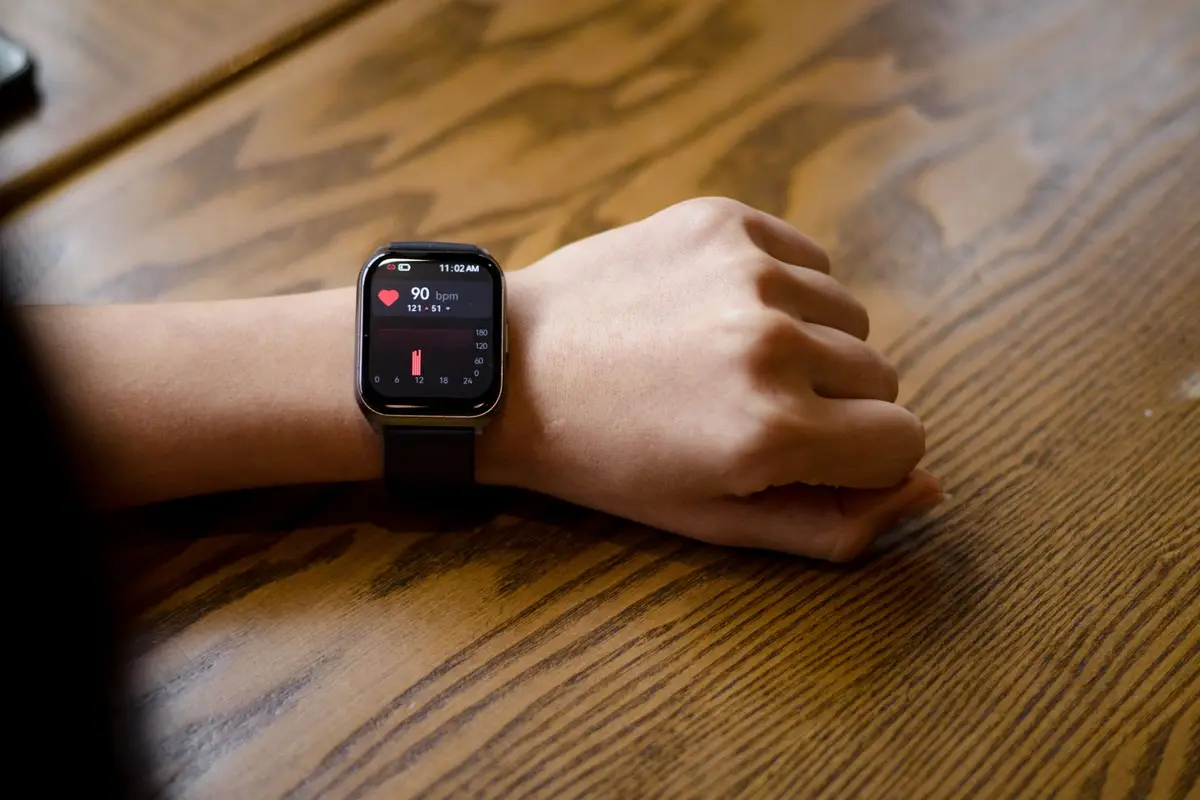
スマートウォッチから不規則な心拍の通知が届いても、それだけで心房細動が確定したわけではない。光学式センサーによる通知は疑いを拾う入口であり、診断には医師が確認する心電図記録が要る。
中国本土ではApple Intelligenceの機能が提供されず、海外で購入した対応端末にも利用条件が設けられてきた。中国当局は2026年7月に「Apple智能」の届け出情報を公表し、AlibabaとBaiduが現地版の開発に加わった。
病院どうしがAIを共同で開発したくても、カルテを院外に出すには高い法的なハードルがある。連合学習は、データを動かす代わりにモデルを各病院へ巡回させ、返すのは学習後の重みの更新だけという設計をとる。
糖尿病網膜症の眼底検査を眼科以外の診療現場へ広げる手段として、判定まで自動化するAI医療機器の開発が進む。米国では携帯型眼底カメラに対応した製品が承認された一方、日本では臨床試験の登録は確認できるものの、同等品の承認状況は公開資料だけでは判然としない。
介護の見守り機器は、同じ製品区分にセンサーの方式も判定方法も異なる製品が並び、名称だけでは性能を比べにくい。日本では「AI」の有無より、実環境での検証条件、誤報と見逃し、取得データの扱いを個別に確かめる必要がある。
健診結果や薬剤情報を生成AIに読ませるサービスでは、回答の精度とデータを預ける仕組みを分けて見る必要がある。米国限定のChatGPT Healthと日本のマイナポータルAPIでは、接続主体と公的審査の範囲が異なる。
生成AIは、根拠のない内容でも流暢で確信に満ちた文章として返す場合がある。ハルシネーションは事前学習で生じ、正解数を重視する評価が不確実な場面での推測を後押しするという分析が示されている。
AIで候補化合物を絞り込む企業への投資が膨らむ一方、AI起点の新薬が承認に達したとの報告はまだない。初期の探索は速くなっても、人体で安全性と有効性を確かめる臨床試験と承認審査は別の関門として残る。
食事の写真を撮ると、グルコースへの影響を生成AIが食前に予測する機能が米国で始まった。日本では現行製品としてFreeStyleリブレ2が案内されており、Libre Assistの国内提供を示す公式資料は確認できていない。
医療AIが薬事承認を得ても、その製品に独立した診療報酬が付くとは限らない。日本の2026年度基準は、既存技術の臨床上の有効性を明らかに高めた場合に加算を検討し、労働時間の短縮だけでは原則として加算しない線を示した。
患者と対話する生成AIが投薬判断に関わる場合、会話の利便性と臨床上の決定権をどう切り分けるかが審査の焦点になる。米FDAが許可したUpDocは、医師が設定した治療計画と決定論的な投薬ロジックを中核に置き、変更可能な範囲も事前に定めた。
電子カルテの項目名やコードが施設ごとに異なれば、AIは同じ意味のデータを同じものとして扱えない。FHIRは医療情報を共通のリソースに分けて交換する規格で、日本の電子カルテ情報共有サービスでも実装が進む。
漢方を扱うAIの実力は、デモ画面の回答や単一の正解率からは判断しにくい。日本で導入を検討する際は、使用目的から医療機器該当性を確かめ、学習資料、性能評価、データ管理、相互運用性、最終判断の責任までを分けて見る必要がある。
免疫学者Derya Unutmaz氏の研究室では、2022年に得たT細胞の実験結果を説明できないまま研究が止まっていた。GPT-5 Proは未発表データから機序の仮説を組み立て、別に行われていたCAR-T細胞の実験結果と同じ方向を予測した。
生成AIが出した化学の仮説は、実験で確かめなければ発見にはならない。GPT-5.4とMolecule.oneの事例は、1万80件を処理する自動実験室と人間による再検証を組み合わせ、探索量を広げた成果だ。